※注意: ChatGPTによる日本語翻訳と並行して読んだので,原文の用語に相当する日本語が正しいかは未検証。
要点
LLMの一般的能力を示す指標としてのMMLUを経験的に求める式「Performance Law」が提案されている。具体的には「層数N」「隠れ次元h」「中間次元d」「学習データ量T」「モデルサイズS」からほぼ導出できると結論付けられている。0.5B~1,000B超級までの様々なモデルに対して,高精度でMMLUを予測できた(特に高品質データを学習した英語モデルで良好)。
一言で言うと: 既知の定量的な指標によって,LLMの精度を予測する経験式の提案
問題設定
これまでLLMに適用できるスケーリング則の変種が様々提案されてきたが,それらは特定の条件下・モデル群に対してのみ有効であることが多く,一般性には限界があった。また,計算基盤の精度や安定性も考慮されておらず,これらはしばしばモデルの精度を損なっていた。
核心
論文では,より実用的で,MMLUを予測する経験式が提案された。特定の環境下における指標ではなく,広くモデルが持っている要素(層数,隠れ次元…)をもとに高精度でモデルの能力を評価することが確認されている。
主な結果
具体的な経験式 - Performance Law
- 層数: [層]
- 隠れ次元: [次元]
- FFNの中間次元: [次元]
- 学習データ数: [trillion tokens]
- モデルサイズ: [billion parameters]
とした場合,まず次のようにモデル飽和クリップ(model saturation clip) を導入する:
また,モデル不安定割引係数(model unstable discount) を次のように定義する:
ここで,は学習基盤における制度損失を反映する係数(小さいほどhealthy model, 大きいとunhealthy)で,デフォルトではとする。
以上を踏まえ,MMLUを予測する対数線形回帰関数を次のように定義する:
ただし,は回帰パラメータであり,著者らはオープンソースモデル10個を用いてそれらの値を得た。
結果
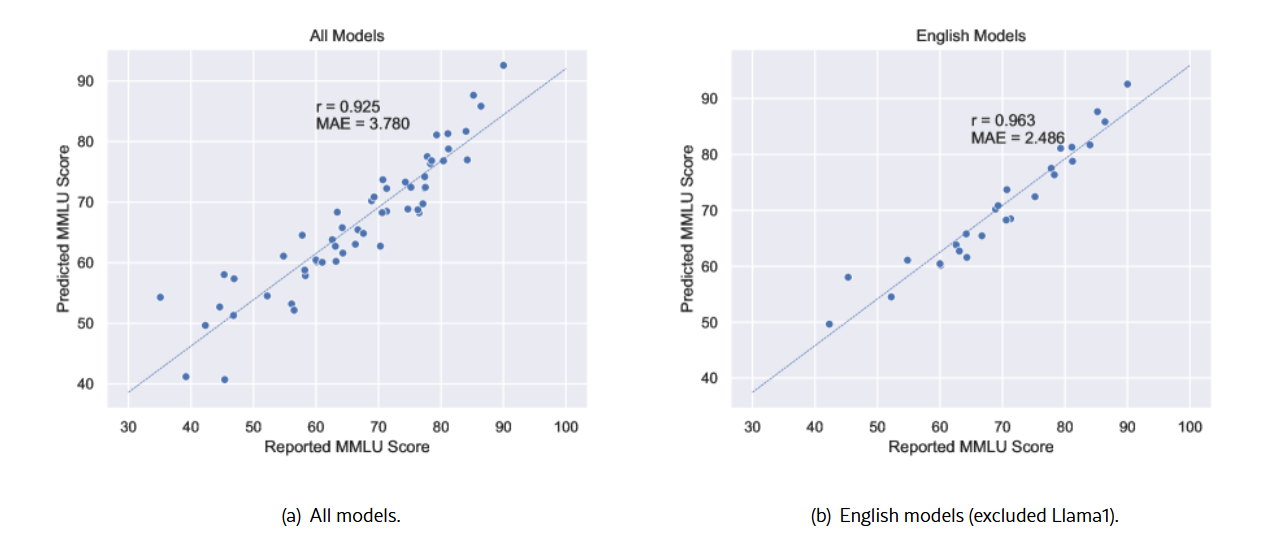
以下に表1と図1を示す。
表1からわかる通り,様々なレンジのモデルに対してかなり高精度で予測を示した。また,図1からもわかる通り,特に高品質なデータで学習された英語指向モデルで良好な結果が得られている。
表1 55モデルの予測値御報告値
| Model | Layer | Hidden | FFN | Expert FFN | d′ | Token / T | Size / B | Act. / B | MoE | MMLU | Prediction | Diff |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Llama 7B | 32 | 4096 | 11008 | - | - | 1 | 7 | - | - | 35.1 | 54.29 | -19.19 |
| Llama 13B | 40 | 5120 | 13824 | - | - | 1 | 13 | - | - | 46.9 | 57.35 | -10.45 |
| Llama 33B | 60 | 6656 | 17920 | - | - | 1.4 | 33 | - | - | 57.8 | 64.53 | -6.73 |
| Llama 65B | 80 | 8192 | 22016 | - | - | 1.4 | 70 | - | - | 63.4 | 68.34 | -4.94 |
| Llama2 7B | 32 | 4096 | 11008 | - | - | 2 | 7 | - | - | 45.3 | 58.03 | -12.73 |
| Llama2 13B | 40 | 5120 | 13824 | - | - | 2 | 13 | - | - | 54.8 | 61.09 | -6.29 |
| Llama2 34B | 48 | 8192 | 22016 | - | - | 2 | 34 | - | - | 62.6 | 63.80 | -1.20 |
| Llama2 70B | 80 | 8192 | 28672 | - | - | 2 | 70 | - | - | 68.9 | 70.21 | -1.31 |
| Llama3.1 8B | 32 | 4096 | 14336 | - | - | 15 | 8 | - | - | 66.7 | 65.43 | 1.27 |
| Llama3.1 70B | 80 | 8192 | 28672 | - | - | 15 | 70 | - | - | 79.3 | 81.09 | -1.79 |
| Llama3.1 405B | 126 | 16384 | 53248 | - | - | 15 | 405 | - | - | 85.2 | 87.64 | -2.44 |
| Gemma 2B | 18 | 2048 | 16384 | - | - | 3 | 2 | - | - | 42.3 | 49.64 | -7.34 |
| Gemma 7B | 28 | 3072 | 24576 | - | - | 6 | 7 | - | - | 64.3 | 61.58 | 2.72 |
| Gemma2 2B | 26 | 2304 | 9216 | - | - | 2 | 2 | - | - | 52.2 | 54.51 | -2.31 |
| Gemma2 9B | 42 | 3584 | 14336 | - | - | 8 | 9 | - | - | 71.3 | 68.48 | 2.82 |
| Gemma2 27B | 46 | 4608 | 36864 | - | - | 13 | 27 | - | - | 75.2 | 72.44 | 2.76 |
| Mistral 7B | 32 | 4096 | 14336 | - | - | 3 | 7 | - | - | 60.1 | 60.14 | -0.04 |
| Mixtral 8*7B | 32 | 4096 | 14336 | 14336 | 8 | 4 | 47 | 13 | ✓ | 70.6 | 68.26 | 2.34 |
| Mixtral 8*22B | 56 | 6144 | 16384 | 16384 | - | 10* | 141 | 39 | ✓ | 77.8 | 77.51 | 0.29 |
| Mistral Large | 88 | 12288 | 28672 | - | - | 7* | 123 | - | - | 81.2 | 78.77 | 2.43 |
| Mistral Large 2 | 88 | 12288 | 28672 | - | - | 12* | 123 | - | - | 84.0 | 81.68 | 2.32 |
| PaLM 540B | 118 | 18432 | 73728 | - | - | 0.78 | 540 | - | - | 69.3 | 70.84 | -1.54 |
| Falcon 180B | 80 | 14848 | 59392 | - | - | 3.5 | 180 | - | - | 70.7 | 73.69 | -2.99 |
| Text-davinci-002 | 96 | 12288 | 49152 | - | - | 0.3 | 175 | - | - | 63.1 | 62.71 | 0.39 |
| GPT-4 | 96* | 12288* | 49152* | 49152* | - | 13 | 1831 | 280 | ✓ | 86.4 | 85.83 | 0.57 |
| PaLM2 340B | 96* | 18432* | 73728* | - | - | 3.6 | 340 | - | - | 78.3 | 76.35 | 1.95 |
| Gemini Ultra | 200* | 32768* | 65536* | - | - | 11 | ∼1760 | - | - | 90.0 | 92.57 | -2.57 |
| Nemotron 15B | 32 | 6144 | 16384* | - | - | 8 | 15 | - | - | 64.2 | 65.78 | -1.58 |
| Nemotron 340B | 96 | 18432 | 73728 | - | - | 9 | 340 | - | - | 81.1 | 81.29 | -0.19 |
| Gopher 280B | 80 | 16384 | 65536 | - | - | 0.3 | 280 | - | - | 60 | 60.45 | -0.45 |
| Deepseek-67B | 95 | 8192 | 22016 | - | - | 2 | 67 | - | - | 71.3 | 72.25 | -0.95 |
| Deepseek-V2 | 60 | 5120 | 1536 | 12288 | - | 8.1 | 236 | 21 | ✓ | 78.5 | 76.83 | 1.67 |
| DeekSeek-V2-Lite | 27 | 2048 | 1408 | 10944 | - | 5.7 | 16 | 2.4 | ✓ | 58.3 | 57.86 | 0.44 |
| Skywork-MoE | 52 | 4608 | 12288 | 12288 | - | 8* | 146 | 22 | ✓ | 77.4 | 74.19 | 3.21 |
| Qwen 1.8B | 24 | 2048 | 11008 | - | - | 2 | 1.8 | - | - | 44.6 | 52.69 | -8.09 |
| Qwen 7B | 32 | 4096 | 22016 | - | - | 2.4 | 7 | - | - | 58.2 | 58.78 | -0.58 |
| Qwen 14B | 40 | 5120 | 27392 | - | - | 3 | 14 | - | - | 66.3 | 63.04 | 3.26 |
| Qwen 72B | 80 | 8192 | 49152 | - | - | 3 | 72 | - | - | 77.4 | 72.24 | 5.16 |
| Qwen 1.5 0.5B | 21 | 1024 | 2816 | - | - | 2.4 | 0.5 | - | - | 39.2 | 41.18 | -1.98 |
| Qwen 1.5 1.8B | 21 | 2048 | 5504 | - | - | 2.4 | 1.8 | - | - | 46.8 | 51.29 | -4.49 |
| Qwen 1.5 4B | 21 | 2560 | 6912 | - | - | 2.4 | 4 | - | - | 56.1 | 53.19 | 2.91 |
| Qwen 1.5 7B | 28 | 4096 | 11008 | - | - | 4 | 7 | - | - | 61.0 | 60.06 | 0.94 |
| Qwen 1.5 14B | 40 | 5120 | 13696 | - | - | 4 | 14 | - | - | 67.6 | 64.83 | 2.77 |
| Qwen 1.5 32B | 64 | 5120 | 27392 | - | - | 7* | 32 | - | - | 74.3 | 73.30 | 1.00 |
| Qwen 1.5 72B | 80 | 8192 | 24576 | - | - | 3 | 72 | - | - | 77.5 | 72.44 | 5.06 |
| Qwen 1.5 110B | 80 | 8192 | 49152 | - | - | 7* | 110 | - | - | 80.4 | 76.81 | 3.59 |
| Qwen 2 0.5B | 24 | 896 | 4864 | - | - | 12 | 0.5 | - | - | 45.4 | 40.70 | 4.70 |
| Qwen 2 1.5B | 28 | 1536 | 8960 | - | - | 7 | 1.5 | - | - | 56.5 | 52.15 | 4.35 |
| Qwen 2 7B | 28 | 3584 | 18944 | - | - | 7 | 7 | - | - | 70.3 | 62.73 | 7.57 |
| Qwen 2 72B | 80 | 8192 | 29568 | - | - | 7 | 72 | - | - | 84.2 | 76.97 | 7.23 |
| Qwen 2 57B-A14B | 28 | 3584 | 18944 | 20480 | - | 11.5 | 57 | 14 | ✓ | 76.5 | 68.24 | 8.26 |
| Yi 6B | 32 | 4096 | 11008 | - | - | 3 | 6 | - | - | 63.2 | 60.22 | 2.98 |
| Yi 34B | 60 | 7168 | 20480 | - | - | 3 | 34 | - | - | 76.3 | 68.73 | 7.57 |
| Yi-1.5 34B | 60 | 7168 | 20480 | - | - | 3.6 | 34 | - | - | 77.1 | 69.72 | 7.38 |
| GLM-4 9B | 40 | 4096 | 13696 | - | - | 10 | 9 | - | - | 74.7 | 68.85 | 5.85 |
(出典: “Performance Law of Large Language Models(Wu & Tang, 2024)“をもとに筆者が再構成)
自分の解釈
- 一般的に広く適用できる経験式。
疑問と確認事項
-
の定義があまり詳しくわかっていない
-
逆算的に,限られた計算予算内での最適なモデルの構造を考えることができるのではないかと考えたが,と仮定している部分など,未知モデルに対する予測式としては過程による不確実性が依然としてあると思った。
-
説明変数同士はそれぞれ互いに独立したパラメータなのか,そうでない場合はより簡易的に予測することができないだろうか(要検証)。
-
モデル不安定割引係数(model unstable discount) から着想を得て,モデルのキャパシティを構成している要素とそれに対する学習量によって新しく「総合健康度」のようなものが定義できるのではないか。
読書履歴
2026-08-10 状態: ざっくり読み 全体を読んだ。次: p3の上部, References
参照先
- “Performance Law of Large Language Models(Wu & Tang, 2024)”
- calculate possible architectures(著者のGitHubリンク)